31 de mayo de 2026
Aprendizaje por Refuerzo: Aprender por Recompensa
Entiende los métodos de aprendizaje basados en recompensa, Q-tables y procesos de decisión de Markov.
El Aprendizaje por Refuerzo (RL) trata sobre un agente que aprende a tomar decisiones interactuando con un entorno y recibiendo recompensas.
El Framework de RL
       ┌──────────────┐
       │    Entorno    │
       └──────┬───────┘
              │ Estado, Recompensa
              ↓
       ┌──────────────┐
       │    Agente     │
       └──────┬───────┘
              │ Acción
              ↓
       ┌──────────────┐
       │    Entorno    │ (siguiente estado)
       └──────────────┘
Elementos clave:
- Agente — el que aprende / toma decisiones
- Entorno — el mundo con el que interactúa el agente
- Estado (s) — situación actual
- Acción (a) — lo que el agente puede hacer
- Recompensa (r) — señal de feedback (positiva o negativa)
- Política (π) — estrategia que mapea estados a acciones
Objetivo: Maximizar la recompensa acumulada a lo largo del tiempo.
Proceso de Decisión de Markov (MDP)
El framework matemático detrás de RL. Un MDP tiene:
- Estados (S) — todas las situaciones posibles
- Acciones (A) — todos los movimientos posibles
- Función de transición T(s, a, s’) — probabilidad de llegar al estado s’ desde el estado s con la acción a
- Función de recompensa R(s, a) — recompensa por tomar la acción a en el estado s
- Factor de descuento (γ) — cuánto valorar recompensas futuras (0 a 1)
Propiedad de Markov: El futuro depende solo del estado actual, no del historial.
$$V(s) = \max_a \left[ R(s,a) + \gamma \sum_{s’} T(s,a,s’) \cdot V(s’) \right]$$
Q-Learning
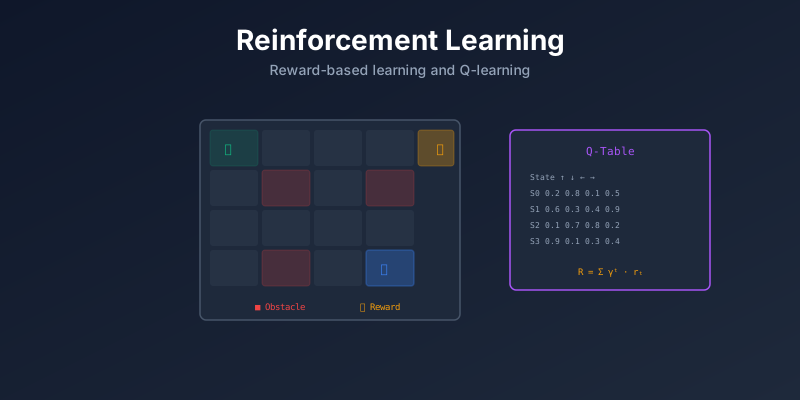
Un algoritmo de RL sin modelo. El agente aprende una Q-table que mapea pares (estado, acción) a recompensas esperadas.
Q-Table
              Acción 1   Acción 2   Acción 3
Estado A      [ 0.5 ]    [ 0.8 ]    [ 0.2 ]
Estado B      [ 0.3 ]    [ 0.1 ]    [ 0.9 ]
Estado C      [ 0.7 ]    [ 0.4 ]    [ 0.6 ]
Regla de Actualización
$$Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma \max_{a’} Q(s’,a’) - Q(s,a) \right]$$
- α = tasa de aprendizaje (qué tan rápido aprender)
- γ = factor de descuento (importancia de recompensas futuras)
Implementación
import numpy as np

# Inicializar Q-table
n_states = 16
n_actions = 4
Q = np.zeros((n_states, n_actions))

# Parámetros
alpha = 0.1      # tasa de aprendizaje
gamma = 0.99     # factor de descuento
epsilon = 0.1    # tasa de exploración

for episode in range(1000):
    state = env.reset()

    while not done:
        # Epsilon-greedy: explorar o explotar
        if np.random.random() < epsilon:
            action = env.action_space.sample()  # explorar
        else:
            action = np.argmax(Q[state])        # explotar

        next_state, reward, done, _ = env.step(action)

        # Actualización Q-learning
        Q[state, action] += alpha * (
            reward + gamma * np.max(Q[next_state]) - Q[state, action]
        )

        state = next_state
Exploración vs Explotación
El dilema central:
- Exploración — probar nuevas acciones para descubrir mejores recompensas
- Explotación — usar la mejor acción conocida
Epsilon-greedy: Con probabilidad ε explorar aleatoriamente, de lo contrario explotar la mejor acción conocida. Disminuir ε con el tiempo.
Métodos Clave de RL
| Método | Descripción |
|---|---|
| Q-Learning | Sin modelo, aprende Q-valores de la experiencia |
| SARSA | Como Q-Learning pero on-policy (usa la acción real siguiente) |
| Deep Q-Network (DQN) | Q-Learning con red neuronal en vez de tabla |
| Policy Gradient | Aprende la política directamente (sin Q-table) |
| Actor-Critic | Combina policy gradient (actor) con función de valor (critic) |
| PPO | Método de policy gradient popular y estable |
Deep RL
Cuando el espacio de estados es demasiado grande para una Q-table (ej. imágenes), usa una red neuronal:
Estado (píxeles) → Red Neuronal → Q-valores para cada acciónimport torch.nn as nn
class DQN(nn.Module):
def __init__(self, n_states, n_actions):
super().__init__()
self.net = nn.Sequential(
nn.Linear(n_states, 128),
nn.ReLU(),
nn.Linear(128, 64),
nn.ReLU(),
nn.Linear(64, n_actions),
)
def forward(self, x):
return self.net(x)Aplicaciones Reales
| Aplicación | Qué Hace RL |
|---|---|
| Juegos | AlphaGo, Atari, Ajedrez |
| Robótica | Aprender a caminar, agarrar objetos |
| Recomendación | Optimizar engagement a largo plazo |
| Trading | Optimizar decisiones de portafolio |
| Gestión de recursos | Auto-escalado cloud, control de tráfico |
Resumen
| Concepto | Idea Clave |
|---|---|
| MDP | Framework matemático: estados, acciones, recompensas, transiciones |
| Q-Learning | Aprender una tabla de valores estado-acción |
| Epsilon-greedy | Equilibrar exploración y explotación |
| Deep RL | Usar redes neuronales para espacios de estado grandes |
| Policy Gradient | Aprender directamente la mejor estrategia |