31 May 2026
Monitoring and Observability
Why monitoring matters for web apps, ML systems, and data platforms. Key tools and practices.
DevOps Infrastructure
Monitoring Observability Prometheus Grafana
Monitoring is critical everywhere — web applications, ML systems, data platforms, and LLM applications. You cannot fix what you cannot see.
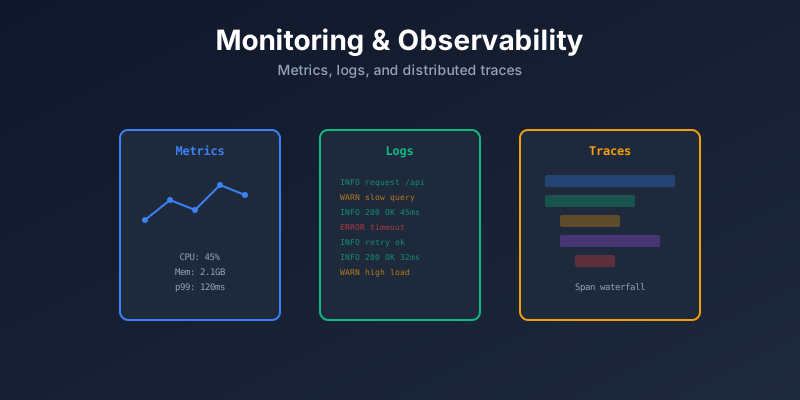
The Three Pillars of Observability
| Pillar | What It Provides | Tools |
|---|---|---|
| Metrics | Numbers over time (CPU, latency, errors) | Prometheus, Datadog, CloudWatch |
| Logs | Detailed event records | ELK Stack, Loki, Splunk |
| Traces | Request flow across services | Jaeger, Zipkin, OpenTelemetry |
Request → Service A → Service B → Database
             │            │          │
          [trace]      [trace]    [trace]
          [metrics]    [metrics]  [metrics]
          [logs]       [logs]     [logs]
Web Application Monitoring
Key Metrics
| Metric | What It Measures | Alert When |
|---|---|---|
| Latency | Response time (p50, p95, p99) | p99 > 500ms |
| Error rate | % of failed requests | > 1% |
| Throughput | Requests per second | Sudden drop |
| Saturation | Resource usage (CPU, memory, disk) | > 80% |
The RED Method (for services)
- Rate — requests per second
- Errors — failed requests per second
- Duration — time per request
The USE Method (for resources)
- Utilization — % of resource being used
- Saturation — work waiting in queue
- Errors — error events
Prometheus + Grafana
# prometheus.yml
scrape_configs:
  - job_name: 'web-app'
    static_configs:
      - targets: ['app:8000']
# Application metrics
from prometheus_client import Counter, Histogram
REQUEST_COUNT = Counter('http_requests_total', 'Total requests', ['method', 'path', 'status'])
REQUEST_LATENCY = Histogram('http_request_duration_seconds', 'Request latency')
@REQUEST_LATENCY.time()
def handle_request():
...
REQUEST_COUNT.labels(method='GET', path='/api/users', status='200').inc()ML/MLOps Monitoring
ML models degrade over time. You must monitor beyond standard app metrics.
What to Monitor
| Category | Metrics |
|---|---|
| Data drift | Input distribution changes vs training data |
| Model drift | Prediction accuracy decreases |
| Prediction latency | Time to generate predictions |
| Feature quality | Missing values, out-of-range values |
| Training metrics | Loss, accuracy per training run |
Training Data Distribution     Production Data Distribution
    ┌─────┐                        ┌─────┐
    │ ▓▓▓ │                        │  ▓▓▓│ ← shifted!
    │▓▓▓▓▓│                        │ ▓▓▓▓│
    │▓▓▓▓▓│                        │▓▓▓▓▓│
    └─────┘                        └─────┘
    Data Drift Detected!
Tools: Evidently AI, Whylabs, Seldon, custom Prometheus metrics
LLM Monitoring
LLMs have unique monitoring needs:
| Metric | Why |
|---|---|
| Token usage | Cost control |
| Response quality | User satisfaction |
| Latency | Time to first token, total response time |
| Hallucination rate | Factual accuracy |
| Guardrail triggers | Safety and compliance |
| RAG retrieval quality | Relevance of retrieved documents |
Data Platform Monitoring
| What to Monitor | Why |
|---|---|
| Pipeline health | Jobs completing on time |
| Data freshness | Data is up to date |
| Data quality | No nulls, correct types, valid ranges |
| Volume | Expected number of rows |
| Schema changes | Breaking changes detected |
| Costs | Cloud spending per team/pipeline |
Tools: Great Expectations, dbt tests, Monte Carlo, Soda
Alerting Best Practices
- Alert on symptoms (high latency), not causes (high CPU)
- Use severity levels: critical (page), warning (ticket), info (log)
- Avoid alert fatigue — too many alerts = all ignored
- Include runbooks — what to do when an alert fires
- Set up on-call rotations
# Alert rule example
- alert: HighErrorRate
  expr: rate(http_requests_total{status="500"}[5m]) > 0.01
  for: 5m
  labels:
    severity: critical
  annotations:
    summary: "Error rate above 1% for 5 minutes"
    runbook: "https://wiki/runbooks/high-error-rate"
Summary
| Context | Key Metrics | Key Tools |
|---|---|---|
| Web apps | Latency, errors, throughput | Prometheus, Grafana, Datadog |
| ML models | Data drift, model accuracy | Evidently, Whylabs |
| LLMs | Token cost, quality, latency | Custom, LangSmith |
| Data platforms | Freshness, quality, pipeline health | Great Expectations, dbt |