31 de mayo de 2026
Monitorización y Observabilidad
Por qué la monitorización importa para aplicaciones web, sistemas ML y plataformas de datos. Herramientas y prácticas clave.
DevOps Infrastructure
Monitorización Observabilidad Prometheus Grafana
La monitorización es crítica en todas partes — aplicaciones web, sistemas ML, plataformas de datos y aplicaciones LLM. No puedes arreglar lo que no puedes ver.
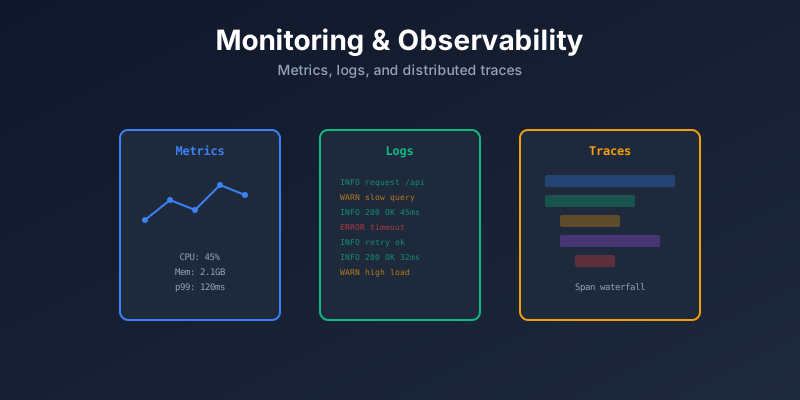
Los Tres Pilares de la Observabilidad
| Pilar | Qué Proporciona | Herramientas |
|---|---|---|
| Métricas | Números en el tiempo (CPU, latencia, errores) | Prometheus, Datadog, CloudWatch |
| Logs | Registros detallados de eventos | ELK Stack, Loki, Splunk |
| Trazas | Flujo de peticiones entre servicios | Jaeger, Zipkin, OpenTelemetry |
Petición → Servicio A → Servicio B → Base de Datos
              │             │            │
           [traza]       [traza]      [traza]
           [métricas]    [métricas]   [métricas]
           [logs]        [logs]       [logs]
Monitorización de Aplicaciones Web
Métricas Clave
| Métrica | Qué Mide | Alertar Cuando |
|---|---|---|
| Latencia | Tiempo de respuesta (p50, p95, p99) | p99 > 500ms |
| Tasa de error | % de peticiones fallidas | > 1% |
| Throughput | Peticiones por segundo | Caída repentina |
| Saturación | Uso de recursos (CPU, memoria, disco) | > 80% |
El Método RED (para servicios)
- Rate — peticiones por segundo
- Errors — peticiones fallidas por segundo
- Duration — tiempo por petición
El Método USE (para recursos)
- Utilization — % del recurso siendo usado
- Saturation — trabajo esperando en cola
- Errors — eventos de error
Prometheus + Grafana
# prometheus.yml
scrape_configs:
  - job_name: 'web-app'
    static_configs:
      - targets: ['app:8000']
# Métricas de la aplicación
from prometheus_client import Counter, Histogram
REQUEST_COUNT = Counter('http_requests_total', 'Total peticiones', ['method', 'path', 'status'])
REQUEST_LATENCY = Histogram('http_request_duration_seconds', 'Latencia de peticiones')
@REQUEST_LATENCY.time()
def handle_request():
...
REQUEST_COUNT.labels(method='GET', path='/api/users', status='200').inc()Monitorización ML/MLOps
Los modelos ML se degradan con el tiempo. Debes monitorizar más allá de las métricas estándar de la app.
Qué Monitorizar
| Categoría | Métricas |
|---|---|
| Data drift | Cambios en la distribución de entrada vs datos de entrenamiento |
| Model drift | La precisión de predicciones disminuye |
| Latencia de predicción | Tiempo para generar predicciones |
| Calidad de features | Valores faltantes, fuera de rango |
| Métricas de entrenamiento | Loss, accuracy por ejecución |
Distribución Datos Entrenamiento   Distribución Datos Producción
    ┌─────┐                            ┌─────┐
    │ ▓▓▓ │                            │  ▓▓▓│ ← ¡desplazado!
    │▓▓▓▓▓│                            │ ▓▓▓▓│
    │▓▓▓▓▓│                            │▓▓▓▓▓│
    └─────┘                            └─────┘
    ¡Data Drift Detectado!
Herramientas: Evidently AI, Whylabs, Seldon, métricas Prometheus personalizadas
Monitorización de LLMs
Los LLMs tienen necesidades de monitorización únicas:
| Métrica | Por Qué |
|---|---|
| Uso de tokens | Control de costes |
| Calidad de respuesta | Satisfacción del usuario |
| Latencia | Tiempo hasta primer token, tiempo total |
| Tasa de alucinación | Precisión factual |
| Activaciones de guardrails | Seguridad y cumplimiento |
| Calidad de recuperación RAG | Relevancia de documentos recuperados |
Monitorización de Plataformas de Datos
| Qué Monitorizar | Por Qué |
|---|---|
| Salud del pipeline | Jobs completándose a tiempo |
| Frescura de datos | Datos actualizados |
| Calidad de datos | Sin nulls, tipos correctos, rangos válidos |
| Volumen | Número esperado de filas |
| Cambios de esquema | Cambios disruptivos detectados |
| Costes | Gasto cloud por equipo/pipeline |
Herramientas: Great Expectations, dbt tests, Monte Carlo, Soda
Buenas Prácticas de Alertas
- Alertar sobre síntomas (alta latencia), no causas (alto CPU)
- Usar niveles de severidad: crítico (pager), warning (ticket), info (log)
- Evitar fatiga de alertas — demasiadas alertas = todas ignoradas
- Incluir runbooks — qué hacer cuando salta una alerta
- Configurar rotaciones de guardia
# Ejemplo de regla de alerta
- alert: AltaTasaDeError
  expr: rate(http_requests_total{status="500"}[5m]) > 0.01
  for: 5m
  labels:
    severity: critical
  annotations:
    summary: "Tasa de error por encima del 1% durante 5 minutos"
    runbook: "https://wiki/runbooks/alta-tasa-error"
Resumen
| Contexto | Métricas Clave | Herramientas Clave |
|---|---|---|
| Apps web | Latencia, errores, throughput | Prometheus, Grafana, Datadog |
| Modelos ML | Data drift, accuracy del modelo | Evidently, Whylabs |
| LLMs | Coste de tokens, calidad, latencia | Custom, LangSmith |
| Plataformas de datos | Frescura, calidad, salud del pipeline | Great Expectations, dbt |