31 de mayo de 2026
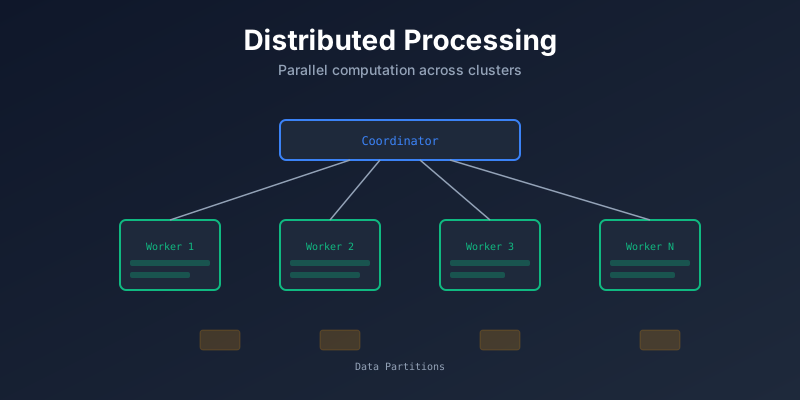
Procesamiento Distribuido
Conceptos clave de sistemas distribuidos, cómo se procesan datos en múltiples máquinas y patrones comunes.
El procesamiento distribuido divide el trabajo entre múltiples máquinas para manejar datos demasiado grandes para un solo ordenador.
¿Por Qué Distribuido?
- Escala — procesar terabytes/petabytes de datos
- Velocidad — procesamiento paralelo es más rápido
- Fiabilidad — si una máquina falla, las otras continúan
- Coste — muchas máquinas baratas vs una cara
Conceptos Clave
Escalado Vertical vs Horizontal
Vertical (Scale Up)          Horizontal (Scale Out)
┌────────────────┐          ┌──────┐ ┌──────┐ ┌──────┐
│ Máquina GRANDE │          │Nodo  │ │Nodo  │ │Nodo  │
│  Más CPU       │          │  1   │ │  2   │ │  3   │
│  Más RAM       │          └──────┘ └──────┘ └──────┘
│  Más Disco     │
└────────────────┘          ← El procesamiento distribuido hace esto
Teorema CAP
Un sistema distribuido solo puede garantizar dos de tres:
| Propiedad | Significado |
|---|---|
| Consistencia | Todos los nodos ven los mismos datos |
| Disponibilidad | Cada petición recibe respuesta |
| Tolerancia a particiones | El sistema funciona a pesar de fallos de red |
En la práctica, las particiones de red ocurren, así que eliges entre CP (consistente) o AP (disponible).
MapReduce
El patrón clásico para procesamiento distribuido de datos:
         ┌──→ Map (Nodo 1) ──→ Shuffle ──→ Reduce (Nodo A) ──┐
Datos ───┼──→ Map (Nodo 2) ──→ Shuffle ──→ Reduce (Nodo B) ──┼──→ Resultado
└──→ Map (Nodo 3) ──→ Shuffle ──→ Reduce (Nodo C) ──┘- Map — procesar cada pieza de datos independientemente
- Shuffle — agrupar resultados por clave
- Reduce — agregar resultados agrupados
Particionamiento (Sharding)
Dividir datos entre nodos:
Datos: usuarios
├── Shard 1: usuarios A-M  → Nodo 1
└── Shard 2: usuarios N-Z  → Nodo 2
Estrategias:
- Basado en hash:
hash(key) % num_shards - Basado en rango: alfabético, por fecha
- Geográfico: por región
Replicación
Copiar datos entre nodos para fiabilidad:
Escritura ──→ Líder ──→ Seguidor 1
                    ──→ Seguidor 2
Lectura ←── cualquier nodo
Patrones Comunes
Procesamiento por Lotes (Batch)
Procesar grandes datasets en horarios programados.
Datos Crudos (HDFS/S3) → Procesar (Spark/MapReduce) → Resultados (BD/Archivos)
                         (se ejecuta por la noche)
Herramientas: Apache Spark, Hadoop MapReduce, AWS EMR
Procesamiento en Streaming
Procesar datos en tiempo real conforme llegan.
Eventos → Cola de Mensajes → Procesar → Salida
          (Kafka)            (Flink)    (BD/Dashboard)
Herramientas: Apache Kafka, Apache Flink, Spark Streaming
Arquitectura Lambda
Combinar procesamiento batch y streaming:
                ┌── Capa Batch (Spark) ──→ Vistas Batch
Fuente de ──────┤
Datos           └── Capa Speed (Flink) ──→ Vistas Tiempo Real
                                                │
                                          Capa de Servicio
                                          (fusiona ambas)
Consenso Distribuido
Cómo los nodos acuerdan valores (elección de líder, locks distribuidos):
- Raft — algoritmo de consenso comprensible
- Paxos — clásico pero complejo
- ZooKeeper — servicio de coordinación
Resumen
| Concepto | Idea Clave |
|---|---|
| MapReduce | Dividir trabajo → procesar → combinar resultados |
| Sharding | Dividir datos entre máquinas |
| Replicación | Copiar datos para fiabilidad |
| Batch | Procesar grandes datos periódicamente |
| Streaming | Procesar datos en tiempo real |
| CAP | Elegir consistencia o disponibilidad |