31 de mayo de 2026
Modelos de Lenguaje: Transformers, RAG y Fine-Tuning
Cómo funcionan los transformers, patrones prácticos como RAG y fine-tuning, y cómo usar bases de datos vectoriales para aplicaciones LLM.
Los Modelos de Lenguaje (LLMs) son la base de los asistentes de IA modernos. Entender cómo funcionan y cómo construir con ellos es esencial.
Cómo Funcionan los Transformers
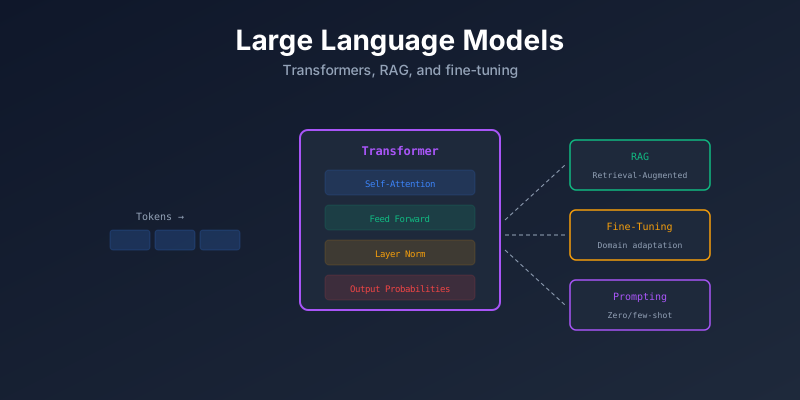
La arquitectura Transformer (2017, “Attention Is All You Need”) es la base de todos los LLMs modernos.
Texto de Entrada → Tokenizer → Embeddings → Bloques Transformer → Salida
                                                    │
                                             Self-Attention
                                                    +
                                              Feed-Forward
Conceptos Clave
| Concepto | Qué Hace |
|---|---|
| Tokenizer | Divide texto en tokens (palabras o subpalabras) |
| Embedding | Convierte tokens en vectores numéricos |
| Self-Attention | Cada token “mira” a todos los demás para entender el contexto |
| Positional Encoding | Añade información de posición (el orden importa) |
| Feed-Forward | Procesa cada token independientemente después de la atención |
Self-Attention (Simplificado)
Para cada palabra, el modelo pregunta: “¿Cuánta atención debo prestar a cada otra palabra?”
"El gato se sentó en la alfombra"

Para "sentó": los pesos de atención podrían ser:
  El=0.1  gato=0.5  se=0.05  sentó=0.1  en=0.15  la=0.0  alfombra=0.1
Tipos de Modelos LLM
| Tipo | Entrenamiento | Ejemplos |
|---|---|---|
| Modelo base | Predecir siguiente token | GPT base, Llama base |
| Instruction-tuned | Seguir instrucciones | ChatGPT, Claude, Llama-Chat |
| Fine-tuned | Especializado para un dominio | Modelos médicos, legales, de código |
Generación Aumentada por Recuperación (RAG)
RAG resuelve el problema de que los LLMs no conocen tus datos privados. En vez de entrenar el modelo, le das documentos relevantes en el momento de la consulta.
Consulta del Usuario
    │
    ↓
┌─────────────┐     ┌──────────────┐
│Embed Consulta│───→│   Vector DB   │
└─────────────┘     │   Buscar      │
                    └──────┬───────┘
                           │ Top-K documentos
                           ↓
                    ┌──────────────┐
                    │ Prompt LLM:   │
                    │Contexto+Query │
                    └──────┬───────┘
                           │
                           ↓
                       Respuesta
Pipeline RAG
# 1. Indexar documentos
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma

# Dividir documentos en chunks
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(documents)

# Almacenar en base de datos vectorial
embeddings = OpenAIEmbeddings()
vectorstore = Chroma.from_documents(chunks, embeddings)

# 2. Consultar
retriever = vectorstore.as_retriever(search_kwargs={"k": 5})
relevant_docs = retriever.get_relevant_documents("¿Cuál es nuestra política de devolución?")

# 3. Generar respuesta
prompt = f"Basándote en estos documentos: {relevant_docs}\n\nResponde: {query}"
response = llm.invoke(prompt)
Fine-Tuning
Adaptar un modelo pre-entrenado a tu dominio o tarea específica.
Cuándo Fine-Tune vs RAG
| Enfoque | Cuándo Usar |
|---|---|
| Prompting | Tareas simples, sin datos personalizados |
| RAG | Necesitas datos privados/actuales, respuestas factuales |
| Fine-tuning | Necesitas estilo, formato o comportamiento de dominio específico |
| Ambos (RAG + FT) | Máximo control y precisión |
LoRA (Low-Rank Adaptation)
Fine-tuning eficiente entrenando solo pequeñas capas adaptadoras:
from peft import LoraConfig, get_peft_model

config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
)

model = get_peft_model(base_model, config)
# Entrenar solo ~1% de los parámetros
Bases de Datos Vectoriales
Almacenan y buscan texto por significado (similitud semántica), no por palabras clave.
"Cómo desplegar una app" → [0.2, 0.8, 0.1, ...] → Similar a:
  - "Guía de despliegue de aplicaciones" (0.92)
  - "Llevar contenedores a producción" (0.85)
  - "Consejos para entrenar perros" (0.12)
Bases de Datos Vectoriales Populares
| Base de Datos | Tipo | Característica Clave |
|---|---|---|
| Chroma | Embebido | Fácil de empezar, nativo de Python |
| Pinecone | Cloud gestionado | Escalable, serverless |
| Weaviate | Self-hosted/cloud | Búsqueda híbrida |
| Qdrant | Self-hosted/cloud | Alto rendimiento |
| pgvector | Extensión PostgreSQL | Usar Postgres existente |
Patrones de Ingeniería LLM
Prompt Engineering
# El system prompt establece el comportamiento
messages = [
    {"role": "system", "content": "Eres un asistente médico útil. "
     "Solo responde basándote en el contexto proporcionado. Di 'No lo sé' si no estás seguro."},
    {"role": "user", "content": "¿Cuáles son los síntomas de..."}
]
Guardrails
Validar las salidas del LLM:
- Verificar contenido dañino
- Validar estructura JSON
- Asegurar que las respuestas se mantengan en tema
- Prevenir inyección de prompts
Evaluación
| Método | Qué Mide |
|---|---|
| Evaluación humana | Calidad, utilidad |
| LLM-como-juez | Puntuación de calidad automatizada |
| BLEU/ROUGE | Similitud de texto con referencia |
| Métricas de recuperación | Precision/recall de docs recuperados |
Resumen
| Concepto | Idea Clave |
|---|---|
| Transformers | Self-attention permite al modelo entender contexto |
| RAG | Dar al LLM documentos relevantes en el momento de la consulta |
| Fine-tuning | Adaptar comportamiento del modelo para tu dominio |
| LoRA | Fine-tuning eficiente (pequeño % de parámetros) |
| Vector DBs | Buscar por significado, no por palabras clave |
| Guardrails | Validar y controlar las salidas del LLM |