31 de mayo de 2026
MLOps: Llevando Modelos a Producción
Cómo desplegar y mantener modelos ML en producción usando Docker, Kubernetes, CI/CD y tracking de experimentos. El lado operacional es el trabajo real.
Entrenar un modelo es quizás el 10% del trabajo. El otro 90% es llevarlo a producción y mantenerlo funcionando. Esto es MLOps.
La Realidad del ML en Producción
┌─────────────────────────────────────────────────────┐
│              Sistema ML en Producción               │
│                                                     │
│  ┌──────────┐  Solo una pequeña fracción es el modelo│
│  │ ML Code  │                                       │
│  └──────────┘                                       │
│  ┌─────────────────────────────────────────────┐    │
│  │ Recolección de Datos, Verificación, Feature  │    │
│  │ Engineering, Config, Infraestructura de      │    │
│  │ Serving, Monitorización, Testing, Gestión... │    │
│  └─────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────┘
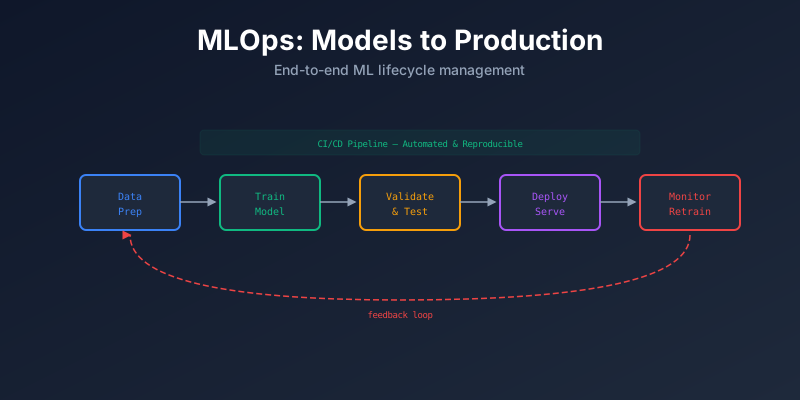
Ciclo de Vida MLOps
Datos → Feature Eng → Entrenar → Evaluar → Empaquetar → Desplegar → Monitorizar
  ↑                                                                    │
  └──────────────────────── Re-entrenar ──────────────────────────────┘
1. Tracking de Experimentos
Registra cada ejecución de entrenamiento para poder reproducir resultados.
Qué registrar:
- Hiperparámetros (learning rate, batch size, epochs)
- Métricas (accuracy, loss, F1)
- Versión del dataset
- Artefactos del modelo
- Versión del código (git commit)
Herramientas: MLflow, Weights & Biases, Neptune, ClearML
import mlflow

with mlflow.start_run():
    mlflow.log_param("learning_rate", 0.01)
    mlflow.log_param("epochs", 100)
    mlflow.log_metric("accuracy", 0.95)
    mlflow.sklearn.log_model(model, "model")
2. Contenedores con Docker
Empaqueta tu modelo y todas las dependencias en un contenedor Docker.
FROM python:3.11-slim

WORKDIR /app
COPY requirements.txt .
RUN pip install -r requirements.txt

COPY model/ ./model/
COPY serve.py .

EXPOSE 8000
CMD ["uvicorn", "serve:app", "--host", "0.0.0.0", "--port", "8000"]
Por qué Docker:
- Mismo entorno en todas partes (dev, staging, prod)
- Sin problemas de “funciona en mi máquina”
- Fácil de escalar y desplegar
3. Serving del Modelo
Expón tu modelo como una API:
from fastapi import FastAPI
import joblib

app = FastAPI()
model = joblib.load("model/model.pkl")

@app.post("/predict")
def predict(data: dict):
    features = preprocess(data)
    prediction = model.predict([features])
    return {"prediction": prediction[0]}
Opciones de serving:
- FastAPI / Flask (API personalizada)
- TensorFlow Serving
- Triton Inference Server
- Seldon Core
- BentoML
4. Kubernetes para Escalar
Despliega contenedores de modelos en Kubernetes para auto-escalado:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-model
spec:
  replicas: 3
  selector:
    matchLabels:
      app: ml-model
  template:
    spec:
      containers:
      - name: model
        image: myregistry/ml-model:v1.2
        resources:
          requests:
            memory: "512Mi"
            cpu: "500m"
          limits:
            memory: "1Gi"
            cpu: "1000m"
        ports:
        - containerPort: 8000
Kubernetes te da:
- Auto-escalado basado en tráfico
- Actualizaciones rolling (deploys sin downtime)
- Health checks y auto-reinicio
- Gestión de recursos (CPU, GPU, memoria)
5. CI/CD para ML
Automatiza el pipeline desde el cambio de código hasta el despliegue:
# .github/workflows/ml-pipeline.yml
name: ML Pipeline
on:
  push:
    branches: [main]

jobs:
  train-and-deploy:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Entrenar modelo
        run: python train.py
      - name: Ejecutar tests
        run: pytest tests/
      - name: Build imagen Docker
        run: docker build -t ml-model:${{ github.sha }} .
      - name: Push al registry
        run: docker push myregistry/ml-model:${{ github.sha }}
      - name: Desplegar en K8s
        run: kubectl set image deployment/ml-model model=myregistry/ml-model:${{ github.sha }}
6. Monitorización del Modelo
Los modelos se degradan con el tiempo. Debes monitorizar:
| Qué Monitorizar | Por Qué |
|---|---|
| Data drift | La distribución de datos de entrada cambia |
| Model drift | Las predicciones se vuelven menos precisas |
| Latencia | El tiempo de respuesta aumenta |
| Throughput | Peticiones por segundo |
| Tasa de error | Predicciones fallidas |
Herramientas: Evidently AI, Whylabs, Prometheus + Grafana
7. Registro de Modelos
Lugar central para almacenar y versionar modelos:
Model Registry
├── fraud-detection
│   ├── v1.0 (archivado)
│   ├── v1.1 (staging)
│   └── v1.2 (producción) ← actual
└── recommendation
    ├── v2.0 (producción)
    └── v2.1 (staging)
Herramientas: MLflow Model Registry, SageMaker Model Registry, Vertex AI
Niveles de Madurez MLOps
| Nivel | Descripción |
|---|---|
| 0 | Todo manual — notebooks, deploys manuales |
| 1 | Pipeline de entrenamiento automatizado |
| 2 | Entrenamiento automatizado + CI/CD para despliegue |
| 3 | Automatización completa + monitorización + re-entrenamiento automático |
Resumen
La mayoría del trabajo de ML en producción no es desarrollo de modelos. Es:
- Construir pipelines de datos fiables
- Empaquetar y desplegar modelos
- Monitorizar rendimiento
- Automatizar re-entrenamiento
- Gestionar infraestructura
MLOps hace esto repetible y fiable.