31 de mayo de 2026
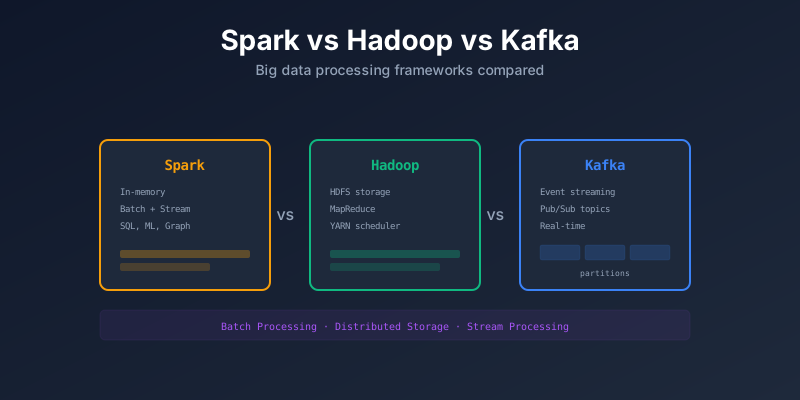
Spark vs Hadoop vs Kafka
Una comparación práctica de Apache Spark, Hadoop y Kafka — qué hace cada uno y cuándo usarlo.
Spark, Hadoop y Kafka son tres pilares de la infraestructura de datos moderna. Resuelven problemas diferentes y a menudo trabajan juntos.
Comparación Rápida
| Spark | Hadoop (MapReduce) | Kafka | |
|---|---|---|---|
| Qué | Motor de computación distribuida | Almacenamiento + computación distribuida | Streaming de eventos distribuido |
| Propósito | Procesar datos (batch + stream) | Almacenar y procesar big data | Mover datos entre sistemas |
| Velocidad | Rápido (en memoria) | Lento (basado en disco) | Tiempo real |
| Datos | Procesa datos | Almacena + procesa datos | Transporta datos |
| Lenguaje | Python, Scala, Java, SQL | Java | Cualquiera (productor/consumidor) |
Hadoop
El framework original de big data (2006). Dos componentes principales:
HDFS — Sistema de Archivos Distribuido de Hadoop
Almacena archivos en múltiples máquinas.
Archivo (300MB)
├── Bloque 1 (128MB) → Nodo 1, Nodo 3 (réplica)
├── Bloque 2 (128MB) → Nodo 2, Nodo 4 (réplica)
└── Bloque 3 (44MB) → Nodo 3, Nodo 1 (réplica)- Los archivos se dividen en bloques (128MB por defecto)
- Cada bloque replicado (3 copias por defecto)
- NameNode rastrea dónde están los bloques
MapReduce
El motor de computación de Hadoop. Lento porque lee/escribe a disco entre pasos.
Entrada → Map (disco) → Shuffle (disco) → Reduce (disco) → SalidaEcosistema Hadoop
| Herramienta | Propósito |
|---|---|
| HDFS | Almacenamiento de archivos distribuido |
| YARN | Gestión de recursos |
| Hive | Consultas SQL sobre Hadoop |
| HBase | Base de datos NoSQL sobre HDFS |
| Pig | Scripting de flujo de datos |
Estado: HDFS se sigue usando, pero MapReduce ha sido reemplazado en gran parte por Spark.
Apache Spark
Un motor de computación distribuida rápido y de propósito general. 10-100x más rápido que MapReduce porque procesa datos en memoria.
Entrada → Transformar (memoria) → Transformar (memoria) → SalidaComponentes de Spark
┌─────────────────────────────────┐
│         Spark SQL               │ ← Consultas SQL
├───────────┬───────────┬─────────┤
│ Spark     │ MLlib     │ GraphX  │
│ Streaming │ (ML)      │ (Grafos)│
├───────────┴───────────┴─────────┤
│        Spark Core (RDDs)        │
├─────────────────────────────────┤
│  YARN / Kubernetes / Standalone │
└─────────────────────────────────┘
Ejemplo PySpark
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("ejemplo").getOrCreate()

# Leer datos
df = spark.read.parquet("s3://bucket/ventas/")

# Transformar
resultado = (df
    .filter(df.año == 2025)
    .groupBy("region")
    .agg({"ingresos": "sum", "pedidos": "count"})
    .orderBy("sum(ingresos)", ascending=False)
)

# Escribir
resultado.write.parquet("s3://bucket/resultados/")
Cuándo Usar Spark
- Procesamiento batch de grandes datasets
- Pipelines ETL/ELT
- Machine learning a escala (MLlib)
- Consultas SQL interactivas (Spark SQL)
- Procesamiento de streams (Structured Streaming)
Apache Kafka
Una plataforma de streaming de eventos distribuida. Piensa en ella como un log permanente y ordenado de eventos.
Productores ──→ Topics de Kafka ──→ Consumidores
                     │
                ┌────┴────┐
                │Partición0│ [msg1, msg2, msg3, ...]
                │Partición1│ [msg1, msg2, ...]
                │Partición2│ [msg1, msg2, msg3, msg4, ...]
                └─────────┘
Conceptos Clave
| Concepto | Qué Es |
|---|---|
| Topic | Una categoría/feed de mensajes |
| Partición | Un topic dividido para paralelismo |
| Productor | Envía mensajes a un topic |
| Consumidor | Lee mensajes de un topic |
| Consumer Group | Múltiples consumidores compartiendo trabajo |
| Offset | Posición de un consumidor en una partición |
| Broker | Un servidor Kafka |
Casos de Uso de Kafka
| Caso de Uso | Cómo |
|---|---|
| Event sourcing | Almacenar todos los cambios de estado como eventos |
| Agregación de logs | Recopilar logs de todos los servicios |
| Procesamiento de streams | Procesar eventos en tiempo real |
| Integración de datos | Conectar bases de datos, apps, data lakes |
| Comunicación de microservicios | Mensajería asíncrona entre servicios |
Kafka Connect
Mover datos entre Kafka y otros sistemas sin código:
Base de Datos ──→ Source Connector ──→ Kafka ──→ Sink Connector ──→ S3
PostgreSQL                             Topic                        Data Lake
Cómo Trabajan Juntos
Apps/BDs ──→ Kafka ──→ Spark Streaming ──→ Data Lakehouse
               │                               │
               └──→ Spark Batch ──────────→ Data Warehouse
                        │
(lee de HDFS/S3)| Capa | Herramienta | Rol |
|---|---|---|
| Transporte | Kafka | Mover eventos en tiempo real |
| Almacenamiento | HDFS / S3 | Almacenar datos crudos a escala |
| Procesamiento | Spark | Transformar y analizar |
| Servicio | Base de Datos / Warehouse | Servir a usuarios |
Resumen
| Herramienta | Usar Cuando |
|---|---|
| Hadoop (HDFS) | Necesitas almacenamiento distribuido barato |
| Spark | Necesitas procesar/transformar grandes datos |
| Kafka | Necesitas transporte de datos en tiempo real entre sistemas |